
- scalability
- peak traffic
- capacity planning
- graceful degradation
Масштабирование iGaming во время live-событий: как защитить финансовые операции при пиковой нагрузке
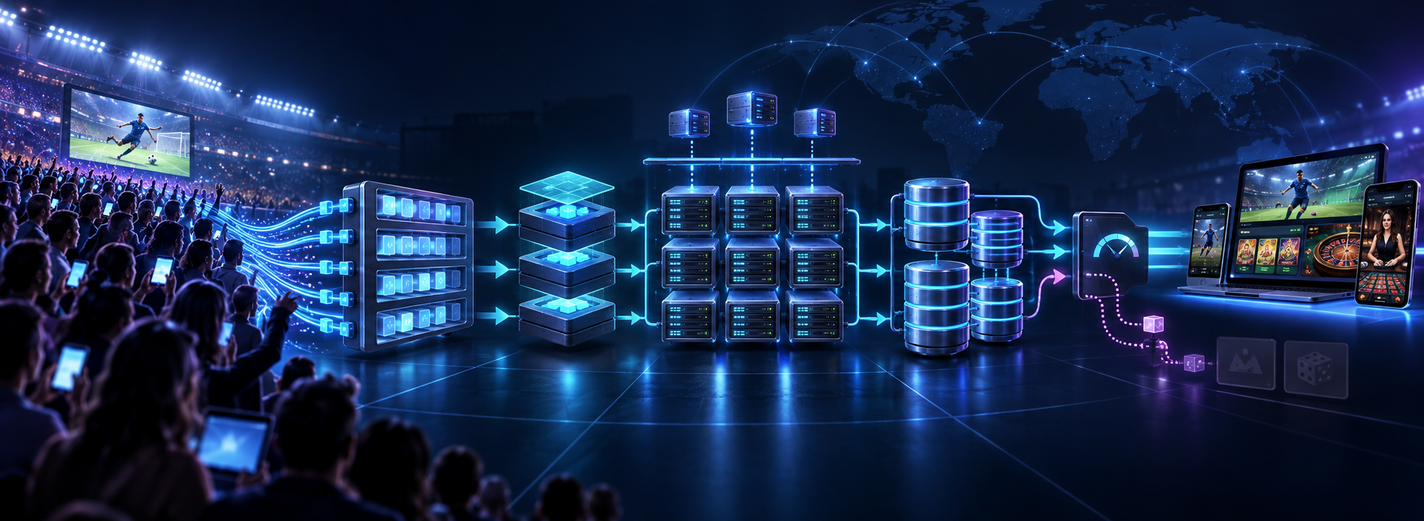
Планируйте пиковую нагрузку с учётом сроков принятия ставок, надёжного расчёта, лимитов зависимостей и измеримого восстановления. В статье — примеры расчёта очереди и бюджета соединений, сценарии испытаний и план работы во время события.
Финальный свисток может сократить поток новых запросов на ставки и одновременно увеличить объём самой важной работы: применения результатов к принятым купонам и завершения операций кошелька. Платформа, которая уверенно работает во время матча, может столкнуться с трудностями после него, если расчёт ставок делит базу и ресурсы обработчиков с волной переподключений игроков или запланированной промокампанией.
Поэтому подготовка к пику требует двух планов: сколько новой работы платформа способна безопасно принять и как она завершит работу, которую уже обязана выполнить для игроков. Это руководство для команд разработки, платформенной инфраструктуры и эксплуатации, готовящих iGaming-сервис к live-событиям. Числовые примеры условные: они показывают способ планирования, а не результаты замеров или рекомендуемые настройки рабочей среды.
Моделируйте событие как несколько потоков работы
По временной шкале события выделите разные виды нагрузки: входы перед началом матча, обновления коэффициентов во время игры, отправку ставок в решающий момент, переподключения после сетевого сбоя и расчёт после получения результатов. Промокампания может одновременно добавить платёжные запросы и проверку бонусных условий. Пики этих потоков не обязательно совпадают, а затраты ресурсов различаются.
Для каждого процесса зафиксируйте характер поступления запросов, обращения к зависимостям, изменения состояния, ключи данных с высокой нагрузкой, ожидаемое время завершения и ответственную команду. Запрос на ставку может потребовать проверки допуска игрока, резервирования средств и вызова поставщика; обновление коэффициентов — рассылки на множество соединений. Общее число запросов в секунду скрывает эту разницу.
Глава Google SRE о перегрузке объясняет, почему количество запросов может плохо отражать потребление ресурсов, и рассматривает квоты клиентов и ограничение потока. Применяйте этот принцип к ограничениям каждого вида работы и бренда: спокойное среднесуточное значение не показывает готовность к событию.
Определите затронутые модули iGaming-платформы и операционную модель букмекерского продукта. Учитывайте общую инфраструктуру: исправный сервис ставок может зависеть от исчерпанного пула аутентификации, перегруженной базы кошелька или квоты поставщика, которую использует другой бренд.
Разделяйте допуск новой работы и уже принятое обязательство
Контроль допуска регулирует работу, которая ещё не принята. У новой live-ставки ограничено время актуальности: пока запрос ждёт, рынок, коэффициент и право игрока сделать ставку могут измениться. Ограничьте ожидание ресурсов, затем проверьте текущие условия в компоненте, уполномоченном принимать решение. Нельзя надолго поставить запрос в очередь и позднее принять старое предложение с экрана, будто ничего не изменилось.
Отказ до принятия и неизвестный исход уже отправленного запроса — разные состояния. Если поставщик или кошелёк зафиксировал операцию, но ответ потерялся, восстановите её исход по стабильному идентификатору. Тайм-аут не даёт права создать новую ставку или повторно переместить деньги. Архитектура ставок, кошелька и расчёта объясняет, какие записи помогают устранить такую неопределённость.
Принятые обязательства требуют надёжного сохранения и обработки. Когда действительный результат создаёт задачу расчёта, сохраните её и связь с купоном. Если это допускает контракт интеграции, проверьте подлинность и корректность входящего события, надёжно сохраните его, затем подтвердите получение; финансовое изменение применяйте через компонент, ответственный за кошелёк, с защитой от повторного эффекта. Подтверждение получения и завершённый расчёт — разные факты.
Ограниченные очереди и обратное давление защищают ресурсы, но на каждой границе нужно определить поведение системы. Если хранилище недоступно или заполнено, не подтверждайте, что событие надёжно получено; действуйте по контракту повторной доставки и сверки с поставщиком и зарегистрируйте инцидент. Просроченный запрос, который ещё не принят, иногда можно отклонить. Незаметно удалить обязательство по расчёту из-за его долгого ожидания нельзя.
Рассчитайте накопление очереди и мощность для её разгрузки
Для планирования очереди нужен расчёт восстановления. Рассмотрим задачи расчёта по уже принятым ставкам: стоимость обработки одинакова, начальной очереди нет, сбоев и повторов нет, а устойчивая скорость обработки фиксирована — 400 задач в секунду. В течение 60 секунд результаты создают 600 задач в секунду.
- Рост: 600 минус 400 — дополнительные 200 задач в секунду.
- Очередь к концу всплеска: 200 умножить на 60 — 12000 незавершённых задач.
- Продолжающийся поток: допустим, после всплеска по-прежнему поступают 200 задач в секунду.
- Мощность для разгрузки: 400 минус 200 — на накопленную очередь остаются 200 задач в секунду.
- Оценка времени разгрузки: 12000 разделить на 200 — при этих допущениях 60 секунд.
Деление размера очереди на полную скорость обработки не учитывает продолжающееся поступление задач. Если поток остаётся на уровне устойчивой скорости завершения или превышает её, без изменений очередь не разгрузится. Дополнительные обработчики помогут лишь тогда, когда ограничивающая зависимость способна поддержать больше завершений.
Измеряйте завершённую работу и возраст самого старого неисполненного обязательства, включая неудачные задачи, перенесённые из активной очереди. Сокращение очереди может скрывать рост числа нерешённых исключений. Учитывайте разную стоимость задач, повторную доставку, лимиты поставщиков, запас хранилища и восстановление после потери обработчика. Арифметика оценивает объём; она не определяет допустимую задержку для игрока и не гарантирует срок. Сопоставляйте оценку времени разгрузки и возраст неисполненных обязательств с согласованной целью процесса, пока очередь ещё не исчерпала допустимое время ожидания; достижение лимита хранилища — поздний сигнал.
Резерв мощности должен соответствовать проверенному сценарию сбоя и согласованным целям сервиса. Укажите, должен ли план выдержать потерю группы обработчиков или ухудшение работы зависимости, и подтвердите это испытанием. Универсальный процент запаса не заменяет эти допущения.
Найдите ограничения, которые не устраняются добавлением экземпляров приложения
Экземпляры приложения могут увеличивать спрос на базу быстрее, чем число завершённых транзакций. В отдельном условном примере 8 экземпляров с максимальным пулом по 40 соединений каждый могут запросить 320 соединений. Это превышает выделенный приложению бюджет в 240 соединений, ещё без учёта других пользователей с отдельными бюджетами.
Распределяйте бюджет пулов между экземплярами, фоновыми обработчиками и операционными инструментами. Оставляйте ресурсы для диагностики и восстановления. Бюджет соединений — ограничение ресурса, а не доказательство, что все разрешённые соединения способны одновременно выполнять полезную работу. На реалистичном объёме данных исследуйте время запросов, ожидание блокировок, скорость записи, длительность транзакций и поведение хранилища.
Найдите ключи данных, к которым особенно часто обращаются. Множество запросов к кошельку одного игрока, общей записи о риске по принятым ставкам или одному популярному событию может выполняться последовательно в одном уполномоченном компоненте. Сохраняйте атомарные проверки баланса, уникальность операций и утверждённые лимиты принятия ставок. Удаление этих проверок ради скорости меняет корректность системы. Лучше сначала рассмотреть разделение независимой работы, сокращение транзакций и перенос необязательных чтений с узла записи.
Лимиты поставщика тоже требуют общего бюджета. Если каждый обработчик отдельно считает доступной всю квоту учётной записи, добавление обработчиков может умножить поток, который по отдельности выглядит допустимым. Соблюдайте реальный общий лимит учётной записи, распределяйте ограниченные доли и определите справедливый доступ брендов и видов работы. Более широкий контекст изоляции даёт мультибрендовая архитектура.
Документация Kubernetes по горизонтальному автомасштабированию описывает периодический цикл управления и влияние готовности и стартовых метрик на его решения. Перед прогнозируемым событием проверьте полезную мощность заранее: сбор метрик, планирование размещения, запуск образа, установка соединений и достижение готовности занимают время. Считайте готовые экземпляры, выполняющие полезную работу, а не только запрошенное число экземпляров.
Выбирайте сигналы масштабирования по характеру ограничения. Загрузка CPU может оставаться низкой, пока обработчики ждут блокировку базы или разрешение поставщика с исчерпанной квотой. Сопоставляйте ресурсы со скоростью завершения и возрастом очереди; ограничивайте параллелизм проверенной мощностью зависимостей. При уменьшении числа экземпляров прекратите приём новых задач, затем завершите текущие или надёжно передайте их до остановки.
Используйте кеширование и ограничение функций без подмены достоверных данных об операциях
Кеширование может устранить повторные чтения публичных данных, но для кешируемого объекта нужны явные правила актуальности и доступа. Размещайте статические ресурсы и подходящие данные лобби ближе к игрокам. Включайте в ключи общего кеша соответствующие бренд, язык и версию конфигурации. Частным данным игрока не место в публичном общем кеше; любой частный кеш защищайте в соответствии с реальными границами идентификации и авторизации.
Показанные коэффициенты — представление предложения, а не доказательство принятия ставки. Отслеживайте их версию и актуальность, а в месте принятия ставки повторно проверяйте коэффициент, доступность рынка, средства и допуск игрока. Устаревший экран не должен разрешать операцию, которую ответственные сервисы отклонили бы. Если необходимые проверки выполнить нельзя, ограничьте соответствующее действие, а не обходите проверки.
Испытывайте холодный кеш наряду с прогретым. Одновременное истечение записей, развёртывание версии или потеря уровня кеширования может направить всплеск запросов к исходному сервису. Ограничивайте параллельные обновления, распределяйте подходящие обновления во времени и прогревайте только рабочий набор, нужный для события. Прогрев всех ключей сам способен вызвать перегрузку.
Согласуйте приоритеты ограничения функций до события. Приостанавливайте дорогие необязательные рекомендации, экспорт отчётов и задачи кампаний, если они угрожают критическим ресурсам. Резервируйте обработку для уже принятой финансовой работы и проверок, необходимых для безопасного обслуживания игроков. Кешированное публичное представление может оставаться полезным, если его актуальность обозначена честно; устаревший баланс не должен служить основанием для расходования денег.
Рекомендации AWS по тайм-аутам, повторам, увеличению интервала и случайному разбросу задержек предупреждают: повторы могут усилить перегрузку, а тайм-аут не доказывает отсутствие эффекта операции. На каждой границе интеграции назначьте одного ответственного за повторы, конечный бюджет попыток и подходящее увеличение интервала со случайным разбросом. Повторяйте операции с побочными эффектами только по проверенным правилам идемпотентности этой интеграции; прежде чем создать новую операцию, выясните результат первоначальной операции, если он ещё неизвестен.
Отделяйте исходный спрос от трафика повторов. При восстановлении зависимости регулируйте повторную обработку и новые вызовы в пределах одного проверенного бюджета. Одновременный запуск всех обработчиков, прогрев всех кешей и выпуск всех отложенных задач может создать следующий пик раньше, чем игроки заметят восстановление.
Испытайте ожидаемый трафик и сбои, которые он может вызвать
Фиксированное число виртуальных пользователей может недооценивать пик, приходящий извне. Если каждый виртуальный пользователь ждёт медленного ответа перед следующим действием, поток новой работы может сокращаться именно тогда, когда платформе тяжело. Grafana k6 объясняет различие закрытой и открытой моделей нагрузки и проблему координированного пропуска измерений. Используйте модель с заданным поступлением работы, когда она соответствует независимым реальным запросам; для процессов, где темп действительно зависит от ответов, сохраняйте сессионную модель.
Фиксируйте нагрузку, которую генератор фактически создал, а не только заданную цель. Убедитесь, что ресурсов и сессий достаточно для нужного характера поступления запросов. Отдельно показывайте поступившую, допущенную, отклонённую и завершённую работу, время завершения и неисполненные обязательства. До испытания определите цели для каждого процесса и бренда: среднее по публичным страницам и записи в кошелёк не даёт полезного критерия приёмки.
- Характер события: проверьте резкий скачок, короткий интенсивный всплеск и длительную нагрузку, включая массовую рассылку коэффициентов и волну расчётов после результатов.
- Характер данных: используйте реалистичные объёмы счетов и купонов, одновременный доступ к нагруженным ключам, один бренд с чрезмерной нагрузкой, холодный и прогретый кеш.
- Сбой зависимости: добавьте задержки поставщика, исчерпание квоты и потерю ответа после фиксации операции; проверьте восстановление исхода без повторного эффекта.
- Сбой обработчика: прервите обработку, повторно доставьте события и перезапустите потребителей; проверьте сохранность обязательств и уникальность эффектов.
- Восстановление: уменьшите поступающую нагрузку, сохранив реалистичный продолжающийся поток. Измеряйте разгрузку очереди, старые исключения и последствия постепенного возвращения необязательных функций.
Проводите испытания со сбоями в изолированной репрезентативной среде с разрешёнными тестовыми интеграциями и данными. После испытания сопоставьте обязательства по купонам с записями кошелька и подтверждениями поставщика. Быстрый ответ API, пустая очередь или отсутствие серверных ошибок сами по себе не доказывают правильный финансовый результат. Это рекомендуемые сценарии проверки, а не утверждение, что данная платформа их прошла.
Управляйте событием по явным правилам и назначьте ответственного за восстановление
Перед событием ответственный инженер должен подтвердить готовую мощность, бюджеты базы, квоты поставщика, запас хранилища и проверенный набор сбоев, который система выдерживает. Эксплуатация должна знать, кто может менять допуск работы, останавливать необязательные задачи, расследовать неизвестные исходы и обращаться к поставщику. Изменения требуют явно заданной области действия, прав доступа и записи аудита.
Используйте операционную инструкцию с наблюдаемыми условиями срабатывания и обратимыми действиями. Если возраст обязательств растёт, а скорость завершения перестала увеличиваться, сначала найдите ограничивающую границу. Приостановите конкурирующую необязательную работу и при необходимости ограничьте новый допуск; добавляйте обработчики только в пределах подтверждённой мощности зависимостей. Если уполномоченный финансовый сервис или сервис допуска игрока недоступен, безопасно остановите затронутые новые операции и сохраните работу с неизвестным исходом для восстановления.
Сообщайте игроку состояние его собственной операции: ожидание, отказ или завершение — по сохранённым подтверждениям. Поддержке нужен безопасный поиск по идентификатору операции или купона, а не совет всем повторить отправку. Не раскрывайте в ответе внутреннюю диагностику поставщика или данные других игроков.
Ответственный за восстановление должен регулировать обработку накопленной очереди, разбирать неудачные задачи и сверять принятые обязательства с проведёнными денежными операциями. Возвращайте необязательную работу постепенно, следя за скоростью завершения и возрастом неисполненных обязательств. Закрывайте инцидент после необходимых финансовых и операционных проверок, а не после снижения входящего потока. Мониторинг незавершённых процессов игрока помогает сделать эти проверки видимыми.
После события сравните прогноз и фактическую нагрузку, готовую мощность, узкие места, решения об ограничении функций и время восстановления. Превратите расхождения в конкретные изменения с ответственными и доказательствами, нужными перед следующим событием. Подготовка к пику становится воспроизводимой, когда команда может объяснить и отказ в новой работе, и завершение принятых обязательств.
Для организационной стороны плана используйте руководство по интеграции продуктовой команды, чтобы уточнить ответственность и операционный контекст. Если работа над мощностью также меняет хранилище или полномочия записи, руководство по миграции действующей платформы рассматривает обязательства и сверку, которые должны сохраниться при переходе.
- Описание нагрузки: временная шкала события, состав процессов и брендов, обращения к зависимостям, сроки, допущения о поступлении запросов и источник каждой оценки.
- Расчёт мощности: измеренные устойчивые скорости завершения, бюджеты базы и поставщиков, время подготовки готовой мощности, хранилище очереди и расчёты разгрузки с продолжающимся поступлением задач.
- План ограничения функций: защищённая финансовая работа и проверки допуска, необязательные функции для приостановки, правила приёма, утверждённые меры управления, сообщения игрокам и ответственность за восстановление.
- Подтверждения: фактически созданная тестовая нагрузка, задержки в медленной части распределения, возраст неисполненных обязательств, результаты сбоев и повторной обработки, данные сверки и действия перед следующим событием.
Нужно ли при каждом пике добавлять экземпляры приложения?
Добавляйте экземпляры, если больше независимой работы приложения может использовать свободную мощность зависимостей. Когда завершение ограничивают блокировки, производительность базы или квота поставщика, дополнительные экземпляры могут увеличить ожидание и число повторов. Найдите ограничение и удерживайте общий параллелизм в пределах проверенного бюджета.
Можно ли удалять задачи расчёта по сроку давности при перегрузке очереди?
Возраст очереди может стать поводом для инцидента или управляемого восстановления, но не отменяет принятое обязательство. Сохраняйте надёжную запись, учитывайте неудачные задачи и разрешайте финансовые последствия через уполномоченный компонент. Для устаревшего запроса на live-ставку, который ещё не принят, правило иное: его можно отклонить до принятия.
Какой запас мощности достаточен?
Полезного универсального процента нет. Сначала выберите прогноз нагрузки, цели сервиса и сценарий сбоя. Измерьте устойчивое завершение в этих условиях, учтите задержку запуска и продолжающееся поступление задач, затем подтвердите, что план позволяет обслуживать защищённую работу и восстановиться в пределах согласованных целей.
Когда команда может считать восстановление завершённым?
Используйте согласованные подтверждения для затронутых процессов: надёжно сохранённые обязательства учтены, финансовые эффекты сверены, неизвестные исходы и неудачные задачи разрешены либо имеют ответственного и утверждённый план, а цели завершения и задержки восстановлены. Снижение трафика или нормальная загрузка CPU сами по себе не доказывают восстановление.
Подготовьте временную шкалу события, текущие метрики процессов, историю очередей и лимиты базы и поставщиков. SPINDO.TECH поможет определить вопросы мощности, меры ограничения функций и проверки, необходимые перед увеличением трафика.
Инсайты
Наблюдаемость iGaming-платформ: как обнаруживать и расследовать частичные сбои
Постройте мониторинг вокруг результатов для игрока, устойчивого учёта платежей и ставок, полезной трассировки и оповещений, требующих действий. Находите остановившиеся процессы даже при исправном API.
14 мин чтения
Как встроить продуктовую команду в iGaming-бизнес: от доступа к ответственности за результат
Дайте новой команде продуктовый контекст, понятный порядок решений и контролируемый доступ. Проверьте взаимодействие на ограниченном первом изменении, используйте план адаптации с доказательствами и проверку передачи знаний.
14 мин чтения
Как спланировать миграцию данных работающей iGaming-платформы
Как перенести данные работающей iGaming-платформы, сохранив балансы, незавершённые операции и ограничения игроков. Правила преобразования, перенос изменений, сверка, переключение и восстановление.
14 мин чтения