
- scalability
- peak traffic
- capacity planning
- graceful degradation
Масштабування iGaming під час live-подій: як захистити фінансові операції за пікового навантаження
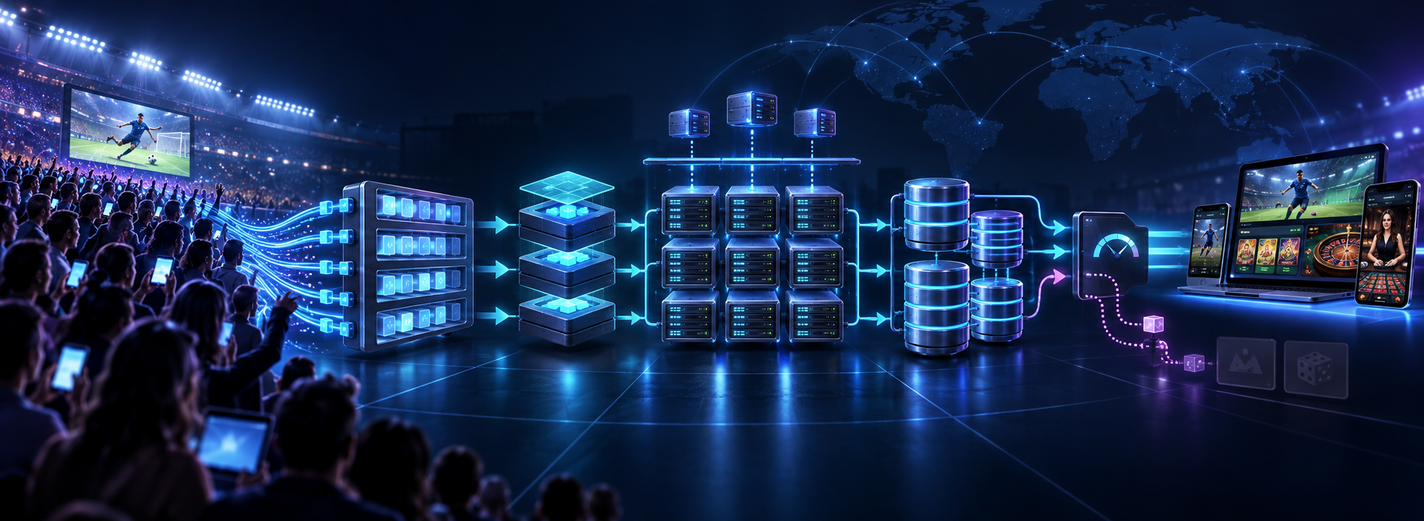
Плануйте пікове навантаження з урахуванням строків прийняття ставок, надійного розрахунку, лімітів залежностей і вимірюваного відновлення. У статті — приклади розрахунку черги й бюджету з’єднань, сценарії випробувань та план роботи під час події.
Фінальний свисток може скоротити потік нових запитів на ставки й водночас збільшити обсяг найважливішої роботи: застосування результатів до прийнятих купонів і завершення операцій гаманця. Платформа, яка впевнено працює під час матчу, може зіткнутися з труднощами після нього, якщо розрахунок ставок ділить базу й ресурси обробників із хвилею повторних підключень гравців або запланованою промокампанією.
Тому підготовка до піку потребує двох планів: скільки нової роботи платформа здатна безпечно прийняти та як вона завершить роботу, яку вже зобов’язана виконати для гравців. Це посібник для команд розробки, платформної інфраструктури й експлуатації, що готують iGaming-сервіс до live-подій. Числові приклади умовні: вони показують спосіб планування, а не результати вимірювань чи рекомендовані налаштування робочого середовища.
Моделюйте подію як кілька потоків роботи
За часовою шкалою події виокремте різні види навантаження: входи перед початком матчу, оновлення коефіцієнтів під час гри, надсилання ставок у вирішальний момент, повторні підключення після мережевого збою та розрахунок після надходження результатів. Промокампанія може одночасно додати платіжні запити й перевірку бонусних умов. Піки цих потоків не обов’язково збігаються, а витрати ресурсів різняться.
Для кожного процесу зафіксуйте характер надходження запитів, звернення до залежностей, зміни стану, ключі даних із високим навантаженням, очікуваний час завершення та відповідальну команду. Запит на ставку може потребувати перевірки допуску гравця, резервування коштів і виклику постачальника; оновлення коефіцієнтів — розсилання на безліч з’єднань. Загальна кількість запитів за секунду приховує цю різницю.
Розділ Google SRE про перевантаження пояснює, чому кількість запитів може погано відображати споживання ресурсів, і розглядає квоти клієнтів та обмеження потоку. Застосовуйте цей принцип до обмежень кожного виду роботи й бренду: спокійне середньодобове значення не показує готовності до події.
Визначте залучені модулі iGaming-платформи та операційну модель букмекерського продукту. Ураховуйте спільну інфраструктуру: справний сервіс ставок може залежати від вичерпаного пулу автентифікації, перевантаженої бази гаманця або квоти постачальника, яку використовує інший бренд.
Розділяйте допуск нової роботи й уже прийняте зобов’язання
Контроль допуску регулює роботу, яку ще не прийнято. Нова live-ставка має обмежений час актуальності: поки запит чекає, ринок, коефіцієнт і право гравця зробити ставку можуть змінитися. Обмежте очікування ресурсів, а тоді перевірте поточні умови в компоненті, уповноваженому ухвалювати рішення. Не можна надовго поставити запит у чергу й пізніше прийняти стару пропозицію з екрана, наче нічого не змінилося.
Відмова до прийняття та невідомий результат уже надісланого запиту — різні стани. Якщо постачальник або гаманець зафіксував операцію, але відповідь загубилася, відновіть її результат за стабільним ідентифікатором. Тайм-аут не дає права створити нову ставку чи повторно перемістити гроші. Архітектура ставок, гаманця й розрахунку пояснює, які записи допомагають усунути таку невизначеність.
Прийняті зобов’язання потребують надійного збереження й обробки. Коли дійсний результат створює завдання розрахунку, збережіть його та зв’язок із купоном. Якщо це допускає контракт інтеграції, перевірте автентичність і коректність вхідної події, надійно збережіть її, а тоді підтвердьте отримання; фінансову зміну застосовуйте через компонент, відповідальний за гаманець, із захистом від повторного ефекту. Підтвердження отримання та завершений розрахунок — різні факти.
Обмежені черги й зворотний тиск захищають ресурси, але на кожній межі потрібно визначити поведінку системи. Якщо сховище недоступне чи заповнене, не підтверджуйте, що подію надійно отримано; дійте за контрактом повторної доставки та звірки з постачальником і зареєструйте інцидент. Прострочений запит, який ще не прийнято, іноді можна відхилити. Непомітно видалити зобов’язання з розрахунку через його тривале очікування не можна.
Розрахуйте накопичення черги й потужність для її розвантаження
Для планування черги потрібен розрахунок відновлення. Розглянемо завдання розрахунку за вже прийнятими ставками: вартість обробки однакова, початкової черги немає, збоїв і повторів немає, а стала швидкість обробки фіксована — 400 завдань за секунду. Протягом 60 секунд результати створюють 600 завдань за секунду.
- Зростання: 600 мінус 400 — додаткові 200 завдань за секунду.
- Черга наприкінці сплеску: 200 помножити на 60 — 12000 незавершених завдань.
- Потік, що триває: припустімо, після сплеску й далі надходять 200 завдань за секунду.
- Потужність для розвантаження: 400 мінус 200 — на накопичену чергу залишаються 200 завдань за секунду.
- Оцінка часу розвантаження: 12000 поділити на 200 — за цих припущень 60 секунд.
Ділення розміру черги на повну швидкість обробки не враховує надходження нових завдань. Якщо потік залишається на рівні сталої швидкості завершення або перевищує її, без змін черга не розвантажиться. Додаткові обробники допоможуть лише тоді, коли залежність, що обмежує систему, здатна підтримати більше завершень.
Вимірюйте завершену роботу та вік найстарішого невиконаного зобов’язання, зокрема невдалих завдань, перенесених з активної черги. Скорочення черги може приховувати зростання кількості нерозв’язаних винятків. Ураховуйте різну вартість завдань, повторну доставку, ліміти постачальників, запас сховища й відновлення після втрати обробника. Арифметика оцінює обсяг; вона не визначає допустиму затримку для гравця й не гарантує строк. Зіставляйте оцінку часу розвантаження та вік невиконаних зобов’язань з узгодженою ціллю процесу, поки черга ще не вичерпала допустимий час очікування; досягнення ліміту сховища — пізній сигнал.
Резерв потужності має відповідати перевіреному сценарію збою та узгодженим цілям сервісу. Укажіть, чи має план витримати втрату групи обробників або погіршення роботи залежності, та підтвердьте це випробуванням. Універсальний відсоток запасу не замінює цих припущень.
Знайдіть обмеження, які не усуваються додаванням екземплярів застосунку
Екземпляри застосунку можуть збільшувати попит на базу швидше, ніж кількість завершених транзакцій. В окремому умовному прикладі 8 екземплярів із максимальним пулом по 40 з’єднань кожен можуть запросити 320 з’єднань. Це перевищує виділений застосунку бюджет у 240 з’єднань, ще без урахування інших користувачів з окремими бюджетами.
Розподіляйте бюджет пулів між екземплярами, фоновими обробниками й операційними інструментами. Залишайте ресурси для діагностики та відновлення. Бюджет з’єднань — обмеження ресурсу, а не доказ, що всі дозволені з’єднання здатні одночасно виконувати корисну роботу. На реалістичному обсязі даних дослідіть час запитів, очікування блокувань, швидкість запису, тривалість транзакцій і поведінку сховища.
Знайдіть ключі даних, до яких звертаються особливо часто. Безліч запитів до гаманця одного гравця, спільного запису про ризик за прийнятими ставками або однієї популярної події може виконуватися послідовно в одному уповноваженому компоненті. Зберігайте атомарні перевірки балансу, унікальність операцій та затверджені ліміти прийняття ставок. Видалення цих перевірок заради швидкості змінює коректність системи. Краще спочатку розглянути розподіл незалежної роботи, скорочення транзакцій і перенесення необов’язкових читань із вузла запису.
Ліміти постачальника також потребують спільного бюджету. Якщо кожен обробник окремо вважає доступною всю квоту облікового запису, додавання обробників може помножити потік, який окремо видається допустимим. Дотримуйтеся реального загального ліміту облікового запису, розподіляйте обмежені частки й визначте справедливий доступ брендів та видів роботи. Ширший контекст ізоляції дає мультибрендова архітектура.
Документація Kubernetes із горизонтального автомасштабування описує періодичний цикл керування та вплив готовності й стартових метрик на його рішення. Перед прогнозованою подією перевірте корисну потужність заздалегідь: збирання метрик, планування розміщення, запуск образу, встановлення з’єднань і досягнення готовності потребують часу. Рахуйте готові екземпляри, що виконують корисну роботу, а не лише запитану кількість екземплярів.
Вибирайте сигнали масштабування за характером обмеження. Завантаження CPU може залишатися низьким, поки обробники чекають блокування бази або дозволу постачальника з вичерпаною квотою. Зіставляйте ресурси зі швидкістю завершення та віком черги; обмежуйте паралелізм перевіреною потужністю залежностей. Під час зменшення кількості екземплярів припиніть прийняття нових завдань, потім завершіть поточні або надійно передайте їх до зупинки.
Використовуйте кешування й обмеження функцій без підміни достовірних даних про операції
Кешування може усунути повторні читання публічних даних, але для кешованого об’єкта потрібні явні правила актуальності й доступу. Розміщуйте статичні ресурси та відповідні дані лобі ближче до гравців. Включайте до ключів спільного кешу відповідні бренд, мову й версію конфігурації. Приватним даним гравця не місце в публічному спільному кеші; будь-який приватний кеш захищайте відповідно до реальних меж ідентифікації та авторизації.
Показані коефіцієнти — представлення пропозиції, а не доказ прийняття ставки. Відстежуйте їхню версію й актуальність, а в місці прийняття ставки повторно перевіряйте коефіцієнт, доступність ринку, кошти та допуск гравця. Застарілий екран не повинен дозволяти операцію, яку відповідальні сервіси відхилили б. Якщо необхідні перевірки виконати неможливо, обмежте відповідну дію, а не обходьте перевірки.
Випробовуйте холодний кеш поряд із прогрітим. Одночасне завершення строку дії записів, розгортання версії або втрата рівня кешування може спрямувати сплеск запитів до вихідного сервісу. Обмежуйте паралельні оновлення, розподіляйте відповідні оновлення в часі й прогрівайте лише робочий набір, потрібний для події. Прогрівання всіх ключів саме здатне спричинити перевантаження.
Узгодьте пріоритети обмеження функцій до події. Призупиняйте дорогі необов’язкові рекомендації, експорт звітів і завдання кампаній, якщо вони загрожують критичним ресурсам. Резервуйте обробку для вже прийнятої фінансової роботи та перевірок, потрібних для безпечного обслуговування гравців. Кешоване публічне представлення може залишатися корисним, якщо його актуальність позначена чесно; застарілий баланс не повинен бути підставою для витрачання грошей.
Рекомендації AWS щодо тайм-аутів, повторів, збільшення інтервалу та випадкового розкиду затримок застерігають: повтори можуть посилити перевантаження, а тайм-аут не доводить відсутності ефекту операції. На кожній межі інтеграції призначте одного відповідального за повтори, кінцевий бюджет спроб і відповідне збільшення інтервалу з випадковим розкидом. Повторюйте операції з побічними ефектами лише за перевіреними правилами ідемпотентності цієї інтеграції; перш ніж створити нову операцію, з’ясуйте невідомий результат початкової.
Відокремлюйте початковий попит від трафіку повторів. Під час відновлення залежності регулюйте повторну обробку й нові виклики в межах одного перевіреного бюджету. Одночасний запуск усіх обробників, прогрівання всіх кешів і випуск усіх відкладених завдань може створити наступний пік раніше, ніж гравці помітять відновлення.
Випробуйте очікуваний трафік і збої, які він може спричинити
Фіксована кількість віртуальних користувачів може недооцінювати пік, що надходить ззовні. Якщо кожен віртуальний користувач чекає повільної відповіді перед наступною дією, потік нової роботи може скорочуватися саме тоді, коли платформі важко. Grafana k6 пояснює відмінність закритої та відкритої моделей навантаження і проблему координованого пропуску вимірювань. Використовуйте модель із заданим надходженням роботи, коли вона відповідає незалежним реальним запитам; для процесів, де темп справді залежить від відповідей, зберігайте сесійну модель.
Фіксуйте навантаження, яке генератор фактично створив, а не лише задану ціль. Переконайтеся, що ресурсів і сесій достатньо для потрібного характеру надходження запитів. Окремо показуйте роботу, що надійшла, допущену, відхилену та завершену роботу, час завершення й невиконані зобов’язання. До випробування визначте цілі для кожного процесу та бренду: середнє за публічними сторінками й записом у гаманець не дає корисного критерію приймання.
- Характер події: перевірте різкий стрибок, короткий інтенсивний сплеск і тривале навантаження, зокрема масове розсилання коефіцієнтів та хвилю розрахунків після результатів.
- Характер даних: використовуйте реалістичні обсяги рахунків і купонів, одночасний доступ до навантажених ключів, один бренд із надмірним навантаженням, холодний і прогрітий кеш.
- Збій залежності: додайте затримки постачальника, вичерпання квоти й втрату відповіді після фіксації операції; перевірте відновлення результату без повторного ефекту.
- Збій обробника: перервіть обробку, повторно доставте події й перезапустіть споживачів; перевірте збереження зобов’язань та унікальність ефектів.
- Відновлення: зменште навантаження, що надходить, зберігши реалістичний потік нових запитів. Вимірюйте розвантаження черги, старі винятки та наслідки поступового повернення необов’язкових функцій.
Проводьте випробування зі збоями в ізольованому репрезентативному середовищі з дозволеними тестовими інтеграціями й даними. Після випробування зіставте зобов’язання за купонами із записами гаманця та підтвердженнями постачальника. Швидка відповідь API, порожня черга або відсутність серверних помилок самі собою не доводять правильного фінансового результату. Це рекомендовані сценарії перевірки, а не твердження, що ця платформа їх пройшла.
Керуйте подією за явними правилами й призначте відповідального за відновлення
Перед подією відповідальний інженер має підтвердити готову потужність, бюджети бази, квоти постачальника, запас сховища та перевірений набір збоїв, який система витримує. Експлуатація має знати, хто може змінювати допуск роботи, зупиняти необов’язкові завдання, розслідувати невідомі результати й звертатися до постачальника. Зміни потребують явно заданої області дії, прав доступу та запису аудиту.
Використовуйте операційну інструкцію зі спостережуваними умовами спрацювання й оборотними діями. Якщо вік зобов’язань зростає, а швидкість завершення перестала збільшуватися, спочатку знайдіть межу, що обмежує систему. Призупиніть конкуруючу необов’язкову роботу та за потреби обмежте новий допуск; додавайте обробники лише в межах підтвердженої потужності залежностей. Якщо уповноважений фінансовий сервіс або сервіс допуску гравця недоступний, безпечно зупиніть відповідні нові операції та збережіть роботу з невідомим результатом для відновлення.
Повідомляйте гравцеві стан його власної операції: очікування, відмову чи завершення — за збереженими підтвердженнями. Підтримці потрібен безпечний пошук за ідентифікатором операції чи купона, а не порада всім повторити надсилання. Не розкривайте у відповіді внутрішню діагностику постачальника або дані інших гравців.
Відповідальний за відновлення має регулювати обробку накопиченої черги, розбирати невдалі завдання та звіряти прийняті зобов’язання з проведеними грошовими операціями. Повертайте необов’язкову роботу поступово, стежачи за швидкістю завершення та віком невиконаних зобов’язань. Закривайте інцидент після необхідних фінансових і операційних перевірок, а не після зниження вхідного потоку. Моніторинг незавершених процесів гравця допомагає зробити ці перевірки видимими.
Після події порівняйте прогноз і фактичне навантаження, готову потужність, вузькі місця, рішення про обмеження функцій і час відновлення. Перетворіть розбіжності на конкретні зміни з відповідальними й доказами, потрібними перед наступною подією. Підготовка до піку стає відтворюваною, коли команда може пояснити і відмову в новій роботі, і завершення прийнятих зобов’язань.
Для організаційної сторони плану використовуйте посібник з інтеграції продуктової команди, щоб уточнити відповідальність та операційний контекст. Якщо робота над потужністю також змінює сховище або повноваження запису, посібник із міграції чинної платформи розглядає зобов’язання та звірку, які мають зберегтися під час переходу.
- Опис навантаження: часова шкала події, склад процесів і брендів, звернення до залежностей, строки, припущення про надходження запитів та джерело кожної оцінки.
- Розрахунок потужності: виміряні сталі швидкості завершення, бюджети бази й постачальників, час підготовки готової потужності, сховище черги та розрахунки розвантаження з подальшим надходженням завдань.
- План обмеження функцій: захищена фінансова робота й перевірки допуску, необов’язкові функції для призупинення, правила прийняття, затверджені засоби керування, повідомлення гравцям і відповідальність за відновлення.
- Підтвердження: фактично створене тестове навантаження, затримки в повільній частині розподілу, вік невиконаних зобов’язань, результати збоїв і повторної обробки, дані звірки та дії перед наступною подією.
Чи потрібно за кожного піку додавати екземпляри застосунку?
Додавайте екземпляри, якщо більше незалежної роботи застосунку може використати вільну потужність залежностей. Коли завершення обмежують блокування, продуктивність бази чи квота постачальника, додаткові екземпляри можуть збільшити очікування та кількість повторів. Знайдіть обмеження й утримуйте загальний паралелізм у межах перевіреного бюджету.
Чи можна видаляти завдання розрахунку за давністю під час перевантаження черги?
Вік черги може стати приводом для інциденту або керованого відновлення, але не скасовує прийнятого зобов’язання. Зберігайте надійний запис, ураховуйте невдалі завдання й розв’язуйте фінансові наслідки через уповноважений компонент. Для застарілого запиту на live-ставку, який ще не прийнято, правило інше: його можна відхилити до прийняття.
Якого запасу потужності достатньо?
Корисного універсального відсотка немає. Спочатку виберіть прогноз навантаження, цілі сервісу та сценарій збою. Виміряйте стале завершення в цих умовах, урахуйте затримку запуску й подальше надходження завдань, а потім підтвердьте, що план дає змогу обслуговувати захищену роботу та відновитися в межах узгоджених цілей.
Коли команда може вважати відновлення завершеним?
Використовуйте узгоджені підтвердження для відповідних процесів: надійно збережені зобов’язання враховано, фінансові ефекти звірено, невідомі результати й невдалі завдання розв’язано або вони мають відповідального та затверджений план, а цілі завершення й затримки відновлено. Зниження трафіку чи нормальне завантаження CPU самі собою не доводять відновлення.
Підготуйте часову шкалу події, поточні метрики процесів, історію черг і ліміти бази та постачальників. SPINDO.TECH допоможе визначити питання потужності, заходи обмеження функцій і перевірки, необхідні перед збільшенням трафіку.
Інсайти
Спостережуваність iGaming-платформ: як виявляти й розслідувати часткові збої
Побудуйте моніторинг навколо результатів для гравця, стійкого обліку платежів і ставок, корисного трасування та сповіщень, що потребують дій. Знаходьте зупинені процеси навіть за справного API.
14 хв читання
Як інтегрувати продуктову команду в iGaming-бізнес: від доступу до відповідальності за результат
Дайте новій команді продуктовий контекст, зрозумілий порядок рішень і контрольований доступ. Перевірте взаємодію на обмеженій першій зміні, використовуйте план адаптації з доказами та перевірку передавання знань.
14 хв читання
Як спланувати міграцію даних чинної iGaming-платформи
Як перенести дані чинної iGaming-платформи, зберігши баланси, незавершені операції та обмеження гравців. Правила перетворення, перенесення змін, звірка, перемикання й відновлення.
14 хв читання